AI Data Evaluation Infrastructure

面向大模型训练与评测高质量数据标注服务

中强智联为 AI 企业提供 AI Coding、多模态与垂类数据服务、法律垂直类服务,帮助模型在真实任务中持续进化。

  • AI Coding
  • 多模态与垂类数据服务
  • 法律垂直类服务

Services

服务能力

围绕 AI Coding、多模态与垂类数据、法律垂直场景,中强智联将模型训练与评测需求拆解为标准、流程、质检与反馈闭环。
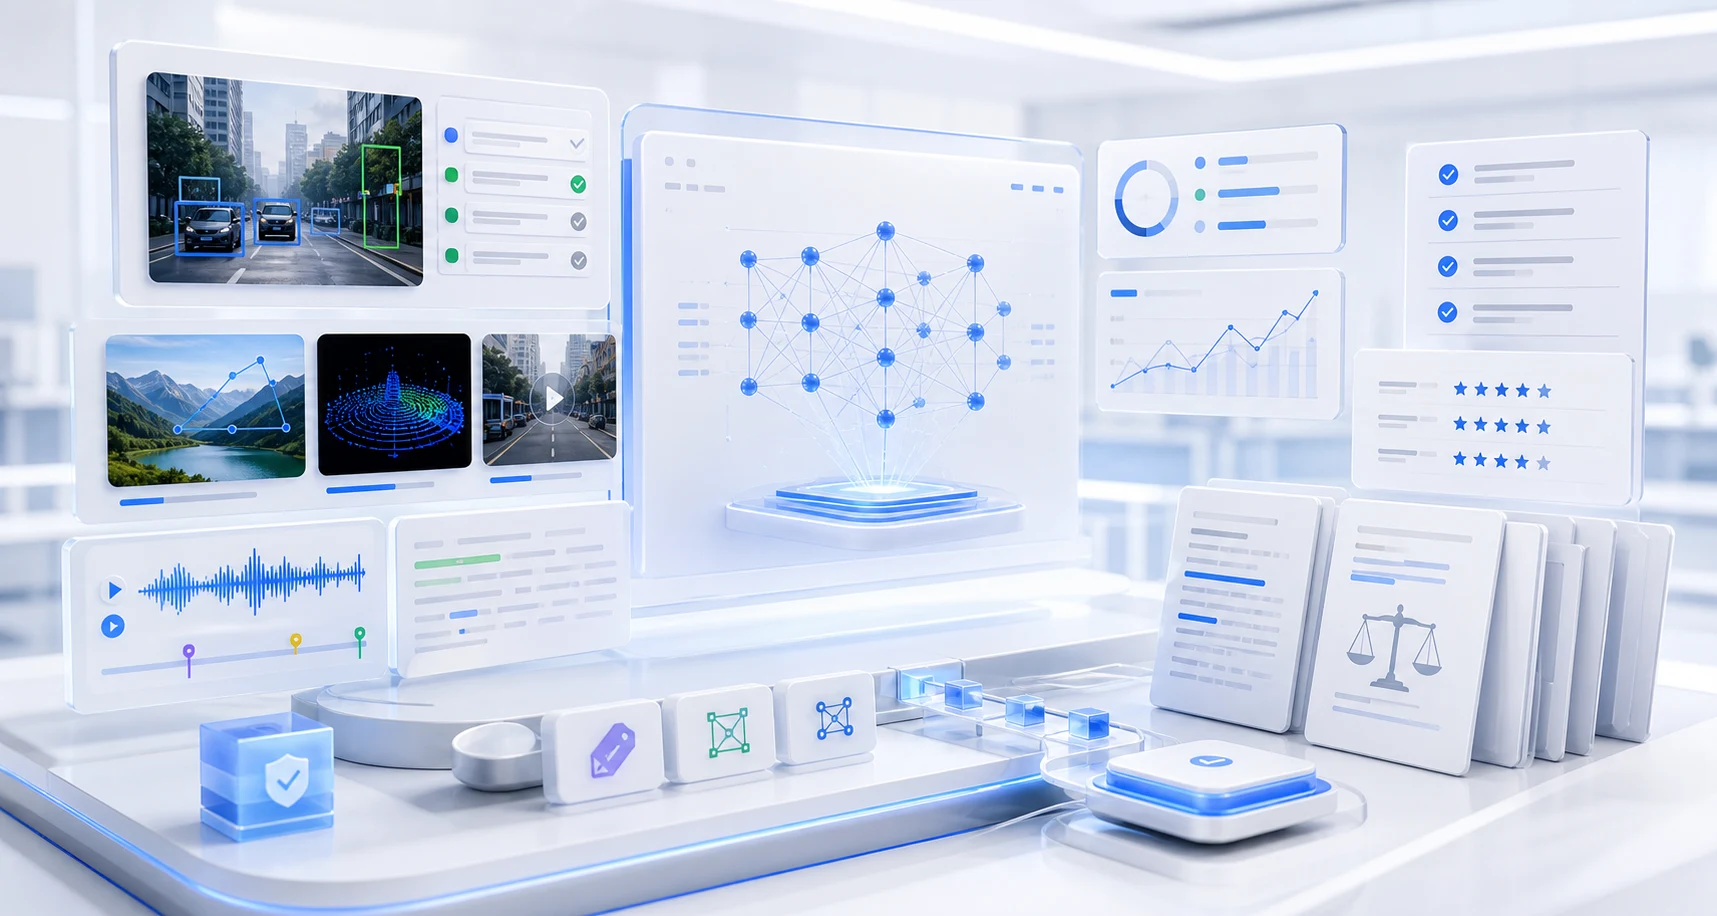
AI Coding 代码评测Multimodal 多模态数据Legal 法律垂直
AI 数据标注、多模态标注、评分质检与模型评测工作台
01

AI Coding

围绕代码生成、Agentic Coding 与工程任务评测,提供 Rubrics 评分量表、代码测评集、执行轨迹审查与质量归因,帮助模型在真实开发任务中稳定提升。

  • Coding Rubrics
  • 代码评测
  • Agent 轨迹
  • Benchmark
02

多模态与垂类数据服务

面向视频、图像、文本及行业知识场景,提供寻源、运镜 caption、图文理解、教育垂类与专业语料建设,让多模态和垂类模型获得可训练、可评测的数据基础。

  • 多模态
  • Caption
  • 寻源
  • 教育垂类
  • 专业语料
03

法律垂直类服务

针对法律文本理解、案例事实抽取、法条关联、问答评测与知识增强任务,建设专业标注标准和质检流程,支持法律垂类模型训练、评测与落地。

  • 法律
  • 案例抽取
  • 法条关联
  • 问答评测
  • 知识增强

Case Studies

案例精选

代码生成模型评测

代码 Rubrics 评分量表建设

围绕前端、数据分析和工程实现任务,拆解需求理解、功能完成度、代码质量、视觉还原、指令遵从等评分维度。
交付价值形成可复用的评分标准、标注流程和质量归因口径,帮助客户稳定衡量模型代码产物质量。
  • Rubrics
  • 代码评测
  • 前端评测
咨询案例方案
抽象的模型评测与数据质量复核界面

Agentic Coding / SFT 数据

Agent 执行轨迹与指令拆解评审

对复杂任务中的计划、工具调用、执行路径、错误修正和最终结果进行过程级标注,识别模型在真实任务中的薄弱环节。

交付价值沉淀轨迹数据、原子能力拆解和失败模式标签,为 SFT 与能力评测提供高质量过程数据。
  • SFT Trajectory
  • Coding Agent
  • Benchmark

UI 生成与前端交付评审

前端产物质量验收标注

针对页面还原度、交互完整性、响应式表现、文本溢出、状态覆盖和可用性进行结构化评审。

交付价值输出问题清单、评分结果与可追踪反馈,支持前端生成模型的迭代和验收标准统一。
  • 前端评测
  • 用户体验
  • 质量归因

视频理解 / 图文融合

多模态运镜 Caption 标注

围绕视频片段中的镜头语言、主体变化、场景线索和时间顺序进行描述标注,增强模型对视觉过程的理解。

交付价值交付规范化 caption 数据和审核结果,用于多模态模型训练、评测和语义对齐。
  • 多模态
  • Caption
  • 视频理解

专业领域数据建设

法律与教育垂类语料标注

结合行业语境进行任务拆解、内容理解、答案校验和结构化反馈,服务垂类模型训练与知识增强。

交付价值构建可审核、可扩展的垂类数据资产,支持专业场景下的模型表现评估。
  • 法律
  • 教育
  • 垂类语料

Partners

合作伙伴

合作与服务经验覆盖互联网平台、内容产品、终端品牌与 AI 团队。品牌展示可按正式授权口径继续增减调整。

  • 阿里巴巴互联网平台
  • 美团生活服务平台
  • 小米智能终端与生态
  • 字节跳动内容与 AI 产品
  • 掌阅数字阅读产品
  • 幻方量化AI 与量化团队

Contact

把复杂的数据任务交给可靠的交付团队

无论是模型评测、数据标注、垂类语料建设,还是 Agent 轨迹数据生产,中强智联都可以与你一起定义标准、搭建流程并稳定交付。
01 定义标准02 搭建流程03 稳定交付